4. IA : agents et modèles locaux
4.4 Modèles locaux : llama.cpp et les GGUF
Des modèles de langage sur le PC, sans réseau et sans compte : le serveur, le chat dans le navigateur, le modèle de Pi, télécharger depuis le catalogue ou depuis Hugging Face.
Dans l'application: «IA › Modèles locaux»
En bref
- Un modèle local est un modèle de langage qui tourne sur votre PC : pas de réseau, pas de compte, pas de forfait. Il tourne sur le processeur ou sur la carte graphique (Vulkan sur Windows et Linux, Metal sur macOS).
- Le serveur est llama.cpp, les modèles sont des fichiers GGUF : ils se téléchargent depuis la page IA, volet « Modèles locaux », depuis le catalogue d'Atollo ou depuis Hugging Face.
- Pi et un chat dans le navigateur les utilisent. Le serveur n'écoute que sur ce PC, avec une clé.
- Un téléchargement suspendu ou interrompu reprend là où il s'était arrêté, même après la fermeture d'Atollo.
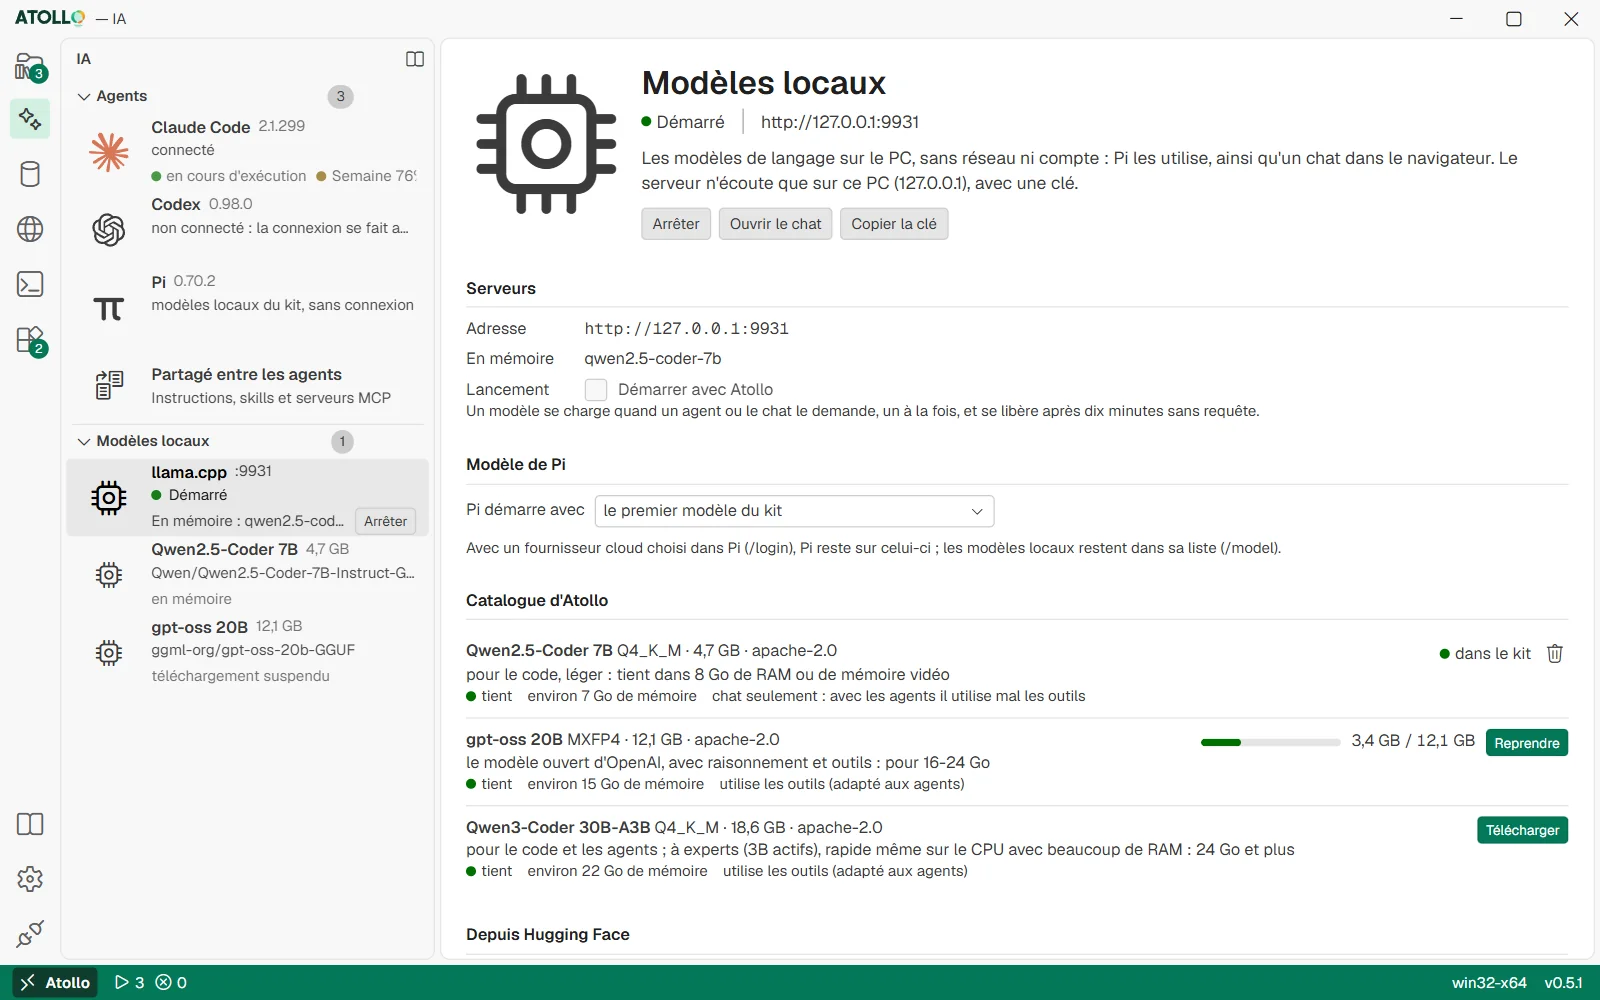
À gauche le serveur et les modèles du kit ; à droite le serveur avec son adresse et sa clé, le modèle de Pi, le catalogue d'Atollo avec un téléchargement suspendu et Hugging Face.
Ce qu'ils sont et ce qu'il faut
Un modèle GGUF est un seul fichier (parfois divisé en parties) avec les poids du modèle déjà compressés : la « quantification » (Q4_K_M, Q8_0, MXFP4…) dit à quel point, et plus elle est basse, plus le fichier est petit et moins il est précis. Le serveur llama.cpp charge le modèle dans la mémoire de la carte graphique s'il y en a assez, sinon il le partage entre la carte graphique et la RAM ou utilise seulement le processeur. Le choix est automatique : llama.cpp s'installe la première fois que vous démarrez le serveur, une seule version par système, vérifiée avec son SHA-256.
Les modèles occupent de nombreux Go et demandent de la mémoire : un modèle de 7 à 9 milliards de paramètres tient dans environ 8 Go, un de 30 milliards en demande plus de 20. Ils sont moins capables que les modèles dans le cloud de Claude Code ou Codex, mais ils restent sur votre PC.
La page IA : le volet « Modèles locaux »
C'est le deuxième volet de la page IA, sous les agents ; la page s'ouvre depuis la barre d'activité (l'icône de l'étincelle). Le nombre à côté du titre compte les modèles complets. Les lignes : le serveur llama.cpp avec son état, son port et le bouton « Démarrer » ou « Arrêter », puis les modèles téléchargés (« modèle de Pi », « en mémoire », « téléchargement suspendu »). Au survol du titre apparaissent « Actualiser les modèles » et « Ouvrir le dossier des modèles ». Quand vous choisissez le serveur ou un modèle, en haut à droite se trouvent « Démarrer » ou « Arrêter », « Ouvrir le chat » et « Copier la clé ». En dessous, les sections :
| Section | Ce qu'elle contient |
|---|---|
| Serveur | L'adresse (http://127.0.0.1:<port>), les modèles en mémoire et « Démarrer avec Atollo », pour allumer le serveur à l'ouverture de l'application. « Démarrer » reste désactivé tant qu'aucun modèle n'est téléchargé. |
| Modèle de Pi | « Pi démarre avec » : un modèle téléchargé, ou « le premier modèle du kit ». Avec un fournisseur dans le cloud choisi dans Pi (/login), Pi reste sur celui-ci ; les modèles locaux restent dans sa liste (/model). |
| Catalogue d'Atollo | Les modèles choisis pour le kit, chacun avec quantification, taille, licence, la mémoire qu'il demande, s'il tient sur ce PC et s'il utilise les outils. « Télécharger », puis « Suspendre » ou « Reprendre » ; la corbeille le supprime. |
| Autres modèles dans le kit | Les modèles pris sur Hugging Face et les fichiers .gguf placés à la main dans le dossier des modèles. |
| Depuis Hugging Face | N'importe quel dépôt (propriétaire/nom), le choix de la quantification et le jeton pour les modèles à accès contrôlé. |
| Ce PC | La RAM, les cartes graphiques avec leur mémoire (visibles après l'installation de llama.cpp), le système de fichiers du disque du kit avec l'espace libre, et le dossier des modèles. |
Choisir et télécharger un modèle
À côté de chaque modèle, la page dit s'il tient sur le PC, en comparant la mémoire qu'il demande avec la plus grande entre la RAM et la mémoire de la carte graphique :
| Texte | Signification |
|---|---|
| tient | Il demande au plus 80 % de cette mémoire : il reste de la marge. |
| à la limite | Il tient, mais laisse peu au reste du système : il peut être lent. |
| trop grand pour ce PC | Il demande plus de mémoire que le PC n'en a. |
« utilise les outils (adapté aux agents) » signifie que le modèle sait appeler les commandes et lire les fichiers quand il travaille avec Pi ; « chat seulement » signifie qu'il les utilise mal avec les agents (il écrit l'appel comme du texte), mais il convient pour discuter dans le navigateur.
| Modèle du catalogue | Mémoire | Usage |
|---|---|---|
| Qwen2.5-Coder 7B | environ 7 Go | chat seulement ; en deux parties, il tient aussi sur FAT32 |
| Qwen3.5 9B | environ 8 Go | utilise les outils |
| gpt-oss 20B | environ 15 Go | utilise les outils |
| Devstral Small 2 24B | environ 18 Go | utilise les outils |
| Qwen3-Coder 30B-A3B | environ 22 Go | utilise les outils |
- Dans le « Catalogue d'Atollo », choisissez un modèle qui « tient » et « utilise les outils », si vous le voulez pour Pi.
- Appuyez sur « Télécharger ». La barre montre le pourcentage et les Go ; le téléchargement continue même si vous changez de page.
- « Suspendre » l'arrête et garde la partie déjà téléchargée ; « Reprendre » repart de là, même après la fermeture d'Atollo ou après une erreur réseau.
- À la fin, le modèle apparaît dans « Dans le kit » marqué « dans le kit » ; si le serveur est allumé, il redémarre pour le voir.
Depuis Hugging Face
- Dans « Dépôt Hugging Face », écrivez propriétaire/nom du dépôt, par exemple unsloth/Qwen3-8B-GGUF.
- Appuyez sur « Chercher les fichiers GGUF » : le kit lit le dernier commit et regroupe les fichiers par quantification, avec la taille, le nombre de parties, s'il tient sur le PC et la licence.
- Appuyez sur « Télécharger » sur la quantification voulue : le kit télécharge toutes ses parties depuis ce commit, ou aucune. Q4_K_M est en général un bon compromis.
Certains modèles sont à accès contrôlé : on accepte les conditions sur la page du modèle et il faut un jeton Hugging Face. Écrivez-le dans « Jeton Hugging Face » et appuyez sur « Enregistrer le jeton » ; « Retirer le jeton » le supprime. Le jeton est enregistré dans le kit, lisible seulement par votre utilisateur, et ne va qu'à huggingface.co : il ne suit pas la redirection vers le CDN d'où viennent les fichiers.
Le chat dans le navigateur
- Appuyez sur « Démarrer » (ou laissez faire « Démarrer avec Atollo »). La première fois, le kit installe llama.cpp.
- Appuyez sur « Copier la clé » : la clé du serveur va dans le presse-papiers.
- Appuyez sur « Ouvrir le chat » : le chat de llama.cpp s'ouvre dans le navigateur. Collez la clé dans ses paramètres, puis choisissez le modèle et écrivez.
Pi n'a pas besoin de ces étapes : le kit écrit le port et la clé dans sa configuration et allume le serveur avant de l'ouvrir, quand il utilise un modèle local.
Sécurité et ressources
- Le serveur n'écoute que sur 127.0.0.1 : aucun autre PC du réseau ne l'atteint, même avec le réseau local activé dans les Paramètres.
- Chaque requête demande la clé du serveur, créée au premier démarrage et donnée au serveur sous forme de fichier, jamais sur la ligne de commande (où d'autres programmes du PC la verraient). Sans clé, le serveur répond 401.
- Un modèle se charge quand Pi ou le chat le demande, un à la fois, et se libère après dix minutes sans requêtes : la mémoire revient au PC.
- Le serveur apparaît dans le panneau « Activité » (avec « Arrêter » et les modèles en mémoire) et s'arrête avec « Tout arrêter », avec « Retirer le lecteur » et à la fermeture de l'application.
- Pendant que vous supprimez un modèle, le serveur s'arrête : sur Windows, un fichier ouvert ne peut pas être supprimé.
Sous le capot
| Fichier ou dossier | Ce qu'il contient |
|---|---|
data\models\gguf\<propriétaire>--<nom>\ | Les modèles, un dossier par dépôt, une seule copie pour Windows, macOS et Linux. atollo.json dit ce que le kit a téléchargé (fichiers, commit, s'il est complet) ; un téléchargement à moitié laisse un fichier .part. |
data\app\secrets\llama-key | La clé du serveur, réservée au propriétaire. |
data\app\secrets\hf-token | Le jeton Hugging Face, réservé au propriétaire. |
data\app\llm.json | Le port du serveur (9931 ou le premier libre après), « Démarrer avec Atollo » et le modèle de Pi. |
data\app\llm\presets.ini | Les modèles que le serveur propose, avec les chemins absolus : il est réécrit à chaque démarrage, car le kit a pu être déplacé. |
data\app\logs\llm.log | La sortie du serveur, à lire s'il ne démarre pas. |
- llama.cpp est figé sur une build (b11669) avec le SHA-256 de l'archive de chaque système : la build Vulkan sur Windows et Linux (qui contient aussi les moteurs pour le processeur), celle Metal sur macOS.
- Les modèles du catalogue sont figés sur un commit de Hugging Face, chaque fichier avec SHA-256 et taille ; ceux pris sur Hugging Face se téléchargent depuis le dernier commit au moment de la recherche.
- Depuis la ligne de commande :
modelsliste les modèles,models pull <modèle>en télécharge un (un id du catalogue ou propriétaire/nom:quantification, reprend si interrompu),models rm <id>le supprime,llm start|stop|statuspilote le serveur.