4. KI: Agenten und lokale Modelle
4.4 Lokale Modelle: llama.cpp und GGUF
Sprachmodelle auf dem PC, ohne Netzwerk und ohne Konto: der Server, der Chat im Browser, das Modell von Pi, Herunterladen aus dem Katalog oder von Hugging Face.
In der App: «KI › Lokale Modelle»
Kurz gesagt
- Ein lokales Modell ist ein Sprachmodell, das auf deinem PC läuft: kein Netzwerk, kein Konto, kein Tarif. Es läuft auf der CPU oder auf der Grafikkarte (Vulkan unter Windows und Linux, Metal unter macOS).
- Der Server ist llama.cpp, die Modelle sind GGUF-Dateien: Du lädst sie auf der Seite KI im Bereich „Lokale Modelle“ herunter, aus dem Katalog von Atollo oder von Hugging Face.
- Pi und ein Chat im Browser verwenden sie. Der Server lauscht nur auf diesem PC, mit einem Schlüssel.
- Ein angehaltener oder unterbrochener Download setzt dort fort, wo er aufgehört hat, auch nachdem du Atollo geschlossen hast.
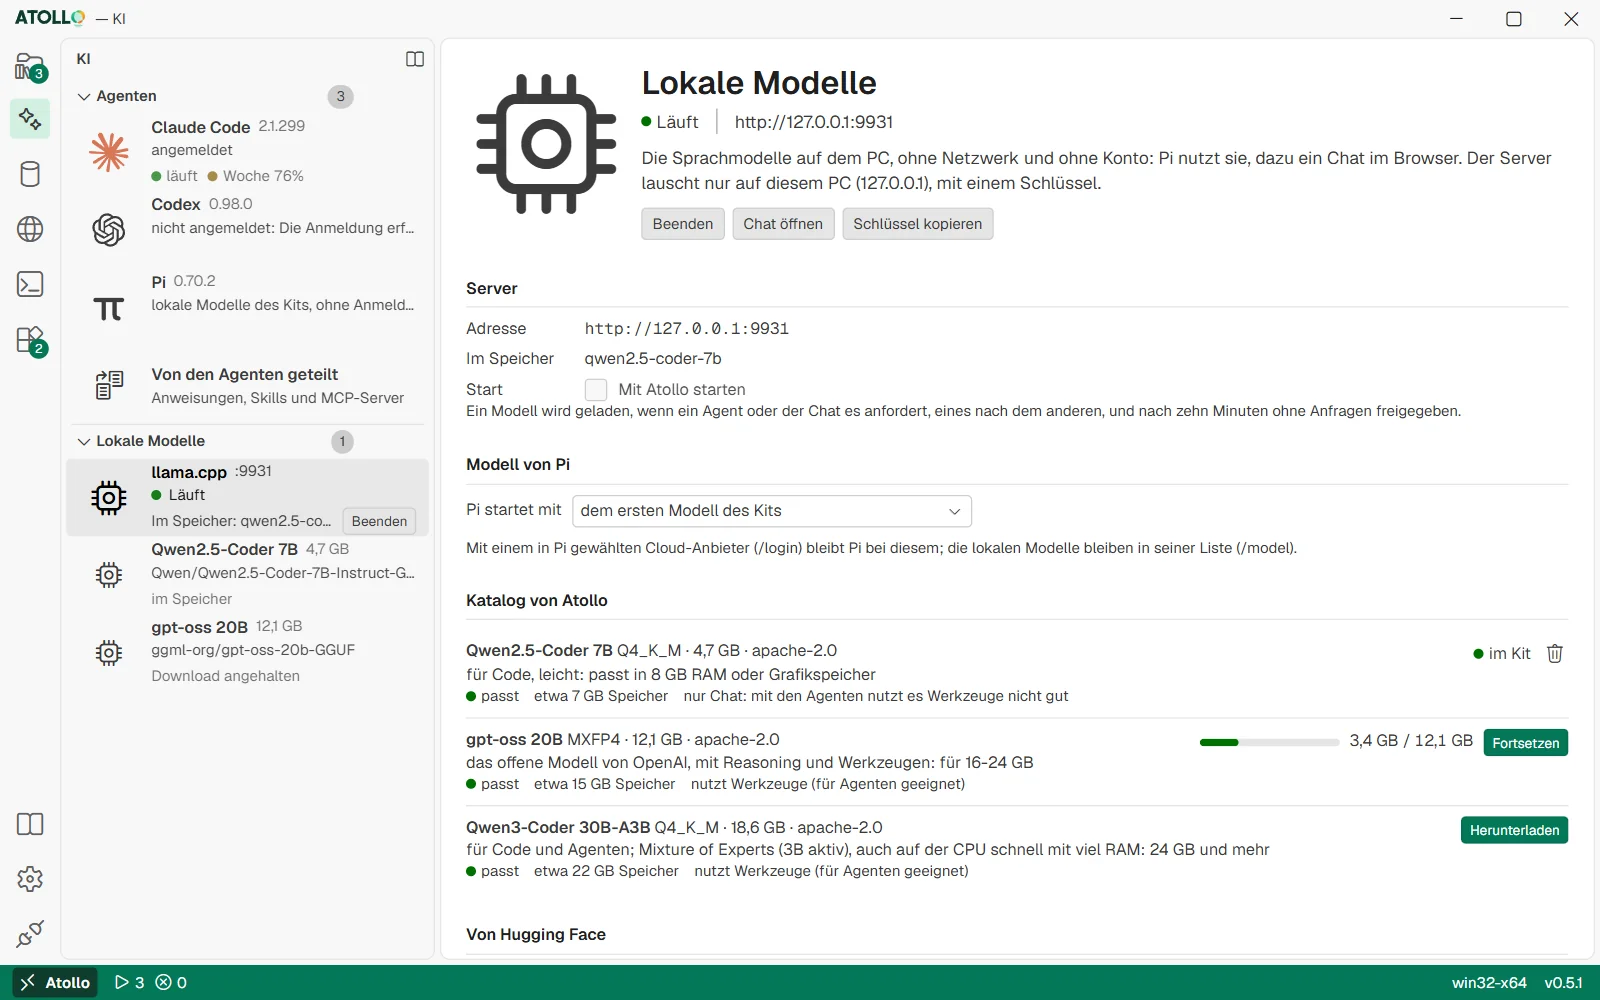
Links der Server und die Modelle im Kit; rechts der Server mit Adresse und Schlüssel, das Modell von Pi, der Katalog von Atollo mit einem angehaltenen Download und Hugging Face.
Was sie sind und was du brauchst
Ein GGUF-Modell ist eine einzige Datei (manchmal in Teile aufgeteilt) mit den bereits komprimierten Gewichten des Modells: Die „Quantisierung“ (Q4_K_M, Q8_0, MXFP4…) gibt an, wie stark, und je niedriger sie ist, desto kleiner die Datei und desto ungenauer das Modell. Der llama.cpp-Server lädt das Modell in den Speicher der Grafikkarte, wenn er reicht, sonst verteilt er es auf Grafikkarte und RAM oder nutzt nur die CPU. Die Wahl erfolgt automatisch: llama.cpp installiert sich beim ersten Start des Servers, eine einzige Version pro System, geprüft mit ihrer SHA-256.
Modelle belegen viele GB und brauchen Speicher: Ein Modell mit 7 bis 9 Milliarden Parametern passt in etwa 8 GB, eines mit 30 Milliarden braucht mehr als 20. Sie sind weniger leistungsfähig als die Cloud-Modelle von Claude Code oder Codex, bleiben aber auf deinem PC.
Die Seite KI: der Bereich „Lokale Modelle“
Es ist der zweite Bereich der Seite KI, unter den Agenten; die Seite öffnet sich über die Aktivitätsleiste (das Funken-Symbol). Die Zahl neben dem Titel zählt die vollständigen Modelle. Die Zeilen: der llama.cpp-Server mit Status, Port und der Schaltfläche „Starten“ oder „Beenden“, dann die heruntergeladenen Modelle („Modell von Pi“, „im Speicher“, „Download angehalten“). Fährst du mit der Maus über den Titel, erscheinen „Modelle aktualisieren“ und „Ordner der Modelle öffnen“. Wählst du den Server oder ein Modell, stehen rechts oben „Starten“ oder „Beenden“, „Chat öffnen“ und „Schlüssel kopieren“. Darunter die Abschnitte:
| Abschnitt | Was er enthält |
|---|---|
| Server | Die Adresse (http://127.0.0.1:<Port>), die Modelle im Speicher und „Mit Atollo starten“, um den Server beim Öffnen der App einzuschalten. „Starten“ bleibt deaktiviert, solange kein Modell heruntergeladen ist. |
| Modell von Pi | „Pi startet mit“: ein heruntergeladenes Modell oder „dem ersten Modell des Kits“. Mit einem in Pi gewählten Cloud-Anbieter (/login) bleibt Pi bei diesem; die lokalen Modelle bleiben in seiner Liste (/model). |
| Katalog von Atollo | Die für das Kit ausgewählten Modelle, jedes mit Quantisierung, Größe, Lizenz, dem benötigten Speicher, ob es auf diesen PC passt und ob es Werkzeuge nutzt. „Herunterladen“, dann „Anhalten“ oder „Fortsetzen“; der Papierkorb löscht es. |
| Weitere Modelle im Kit | Die von Hugging Face geholten Modelle und die von Hand in den Ordner der Modelle gelegten .gguf-Dateien. |
| Von Hugging Face | Ein beliebiges Repository (Eigentümer/Name), die Wahl der Quantisierung und das Token für zugangsbeschränkte Modelle. |
| Dieser PC | Der RAM, die Grafikkarten mit ihrem Speicher (sichtbar nach der Installation von llama.cpp), das Dateisystem des Kit-Laufwerks mit dem freien Platz und der Ordner der Modelle. |
Ein Modell auswählen und herunterladen
Neben jedem Modell sagt die Seite, ob es auf den PC passt, indem sie den benötigten Speicher mit dem größeren von RAM und Grafikspeicher vergleicht:
| Text | Bedeutung |
|---|---|
| passt | Es braucht höchstens 80 % dieses Speichers: Es bleibt Spielraum. |
| knapp | Es passt, lässt aber dem restlichen System wenig übrig: Es kann langsam sein. |
| zu groß für diesen PC | Es braucht mehr Speicher, als der PC hat. |
„nutzt Werkzeuge (für Agenten geeignet)“ bedeutet, dass das Modell Befehle aufrufen und Dateien lesen kann, wenn es mit Pi arbeitet; „nur Chat“ bedeutet, dass es sie mit den Agenten nicht gut nutzt (es schreibt den Aufruf als Text), aber zum Chatten im Browser taugt.
| Modell des Katalogs | Speicher | Verwendung |
|---|---|---|
| Qwen2.5-Coder 7B | etwa 7 GB | nur Chat; in zwei Teilen, passt auch auf FAT32 |
| Qwen3.5 9B | etwa 8 GB | nutzt Werkzeuge |
| gpt-oss 20B | etwa 15 GB | nutzt Werkzeuge |
| Devstral Small 2 24B | etwa 18 GB | nutzt Werkzeuge |
| Qwen3-Coder 30B-A3B | etwa 22 GB | nutzt Werkzeuge |
- Wähle im „Katalog von Atollo“ ein Modell, das „passt“ und „Werkzeuge nutzt“, wenn du es für Pi willst.
- Drück „Herunterladen“. Der Balken zeigt Prozent und GB; der Download läuft weiter, auch wenn du die Seite wechselst.
- „Anhalten“ stoppt ihn und behält den bereits heruntergeladenen Teil; „Fortsetzen“ setzt dort wieder an, auch nachdem du Atollo geschlossen hast oder nach einem Netzwerkfehler.
- Am Ende erscheint das Modell unter „Im Kit“ mit „im Kit“; läuft der Server, startet er neu, um es zu sehen.
Von Hugging Face
- Gib unter „Hugging-Face-Repository“ Eigentümer/Name des Repositorys ein, zum Beispiel unsloth/Qwen3-8B-GGUF.
- Drück „GGUF-Dateien suchen“: Das Kit liest den neuesten Commit und gruppiert die Dateien nach Quantisierung, mit Größe, Anzahl der Teile, ob es auf den PC passt, und der Lizenz.
- Drück „Herunterladen“ bei der gewünschten Quantisierung: Das Kit lädt alle ihre Teile aus diesem Commit herunter oder keinen. Q4_K_M ist meist ein guter Kompromiss.
Manche Modelle sind zugangsbeschränkt: Du akzeptierst die Bedingungen auf der Seite des Modells und brauchst ein Hugging-Face-Token. Gib es unter „Hugging-Face-Token“ ein und drück „Token speichern“; „Token entfernen“ löscht es. Das Token wird im Kit gespeichert, nur für deinen Benutzer lesbar, und geht nur an huggingface.co: Es folgt nicht der Weiterleitung an das CDN, von dem die Dateien kommen.
Der Chat im Browser
- Drück „Starten“ (oder überlass es „Mit Atollo starten“). Beim ersten Mal installiert das Kit llama.cpp.
- Drück „Schlüssel kopieren“: Der Schlüssel des Servers kommt in die Zwischenablage.
- Drück „Chat öffnen“: Der Chat von llama.cpp öffnet sich im Browser. Füge den Schlüssel in seinen Einstellungen ein, wähle dann das Modell und schreib.
Pi braucht diese Schritte nicht: Das Kit schreibt Port und Schlüssel in seine Konfiguration und schaltet den Server ein, bevor es ihn öffnet, wenn er ein lokales Modell verwendet.
Sicherheit und Ressourcen
- Der Server lauscht nur auf 127.0.0.1: Kein anderer PC im Netzwerk erreicht ihn, auch nicht mit aktiviertem lokalem Netzwerk in den Einstellungen.
- Jede Anfrage braucht den Schlüssel des Servers, der beim ersten Start erzeugt und dem Server als Datei übergeben wird, nie in der Befehlszeile (wo andere Programme des PCs ihn sehen würden). Ohne Schlüssel antwortet der Server mit 401.
- Ein Modell wird geladen, wenn Pi oder der Chat es anfordert, eines nach dem anderen, und nach zehn Minuten ohne Anfragen freigegeben: Der Speicher geht an den PC zurück.
- Der Server erscheint im Bereich „Aktivität“ (mit „Beenden“ und den Modellen im Speicher) und stoppt mit „Alles stoppen“, mit „Laufwerk entfernen“ und beim Schließen der App.
- Während du ein Modell löschst, stoppt der Server: Unter Windows lässt sich eine geöffnete Datei nicht löschen.
Unter der Haube
| Datei oder Ordner | Was sie enthält |
|---|---|
data\models\gguf\<Eigentümer>--<Name>\ | Die Modelle, ein Ordner pro Repository, eine einzige Kopie für Windows, macOS und Linux. atollo.json sagt, was das Kit heruntergeladen hat (Dateien, Commit, ob vollständig); ein halber Download hinterlässt eine .part-Datei. |
data\app\secrets\llama-key | Der Schlüssel des Servers, nur für den Eigentümer. |
data\app\secrets\hf-token | Das Hugging-Face-Token, nur für den Eigentümer. |
data\app\llm.json | Der Port des Servers (9931 oder der erste freie danach), „Mit Atollo starten“ und das Modell von Pi. |
data\app\llm\presets.ini | Die Modelle, die der Server anbietet, mit absoluten Pfaden: Die Datei wird bei jedem Start neu geschrieben, weil das Kit verschoben worden sein kann. |
data\app\logs\llm.log | Die Ausgabe des Servers, zum Nachlesen, wenn er nicht startet. |
- llama.cpp ist auf einen Build (b11669) festgelegt, mit der SHA-256 des Archivs jedes Systems: der Vulkan-Build unter Windows und Linux (der auch die CPU-Engines enthält), der Metal-Build unter macOS.
- Die Modelle des Katalogs sind auf einen Hugging-Face-Commit festgelegt, jede Datei mit SHA-256 und Größe; die von Hugging Face geholten werden vom neuesten Commit zum Zeitpunkt der Suche heruntergeladen.
- Über die Kommandozeile:
modelslistet die Modelle auf,models pull <Modell>lädt eines herunter (eine Katalog-ID oder Eigentümer/Name:Quantisierung, setzt nach einer Unterbrechung fort),models rm <id>löscht es,llm start|stop|statussteuert den Server.